不用一小時,使用OpenAI技術和相似詞嵌入從網站創建Q&A聊天機器人
應用OpenAI的熱潮與建立聊天機器人
近年來,隨著人工智能技術的不斷演進,OpenAI已經成為引領這一領域的先鋒之一。其出色的自然語言處理模型,特別是GPT系列,已被廣泛應用於各種領域,為企業和開發者帶來了前所未有的機會。在這篇文章中,我們將探討如何在這股OpenAI的熱潮中,運用其技術來創建一個高效的Q&A聊天機器人,並討論這種方法所帶來的多重益處。
OpenAI的熱潮
OpenAI的自然語言處理模型在近年來取得了巨大的突破,使得機器能夠更加自然地理解和生成人類語言。這種技術已經在機器翻譯、文本摘要、生成文本等領域取得了驚人的成就。特別是GPT-3模型,以其驚人的語言生成能力和多功能性,吸引了全球開發者和企業的目光。由於OpenAI技術的不斷演進,現在是使用這些強大工具來改進我們日常生活和業務流程的最佳時機。
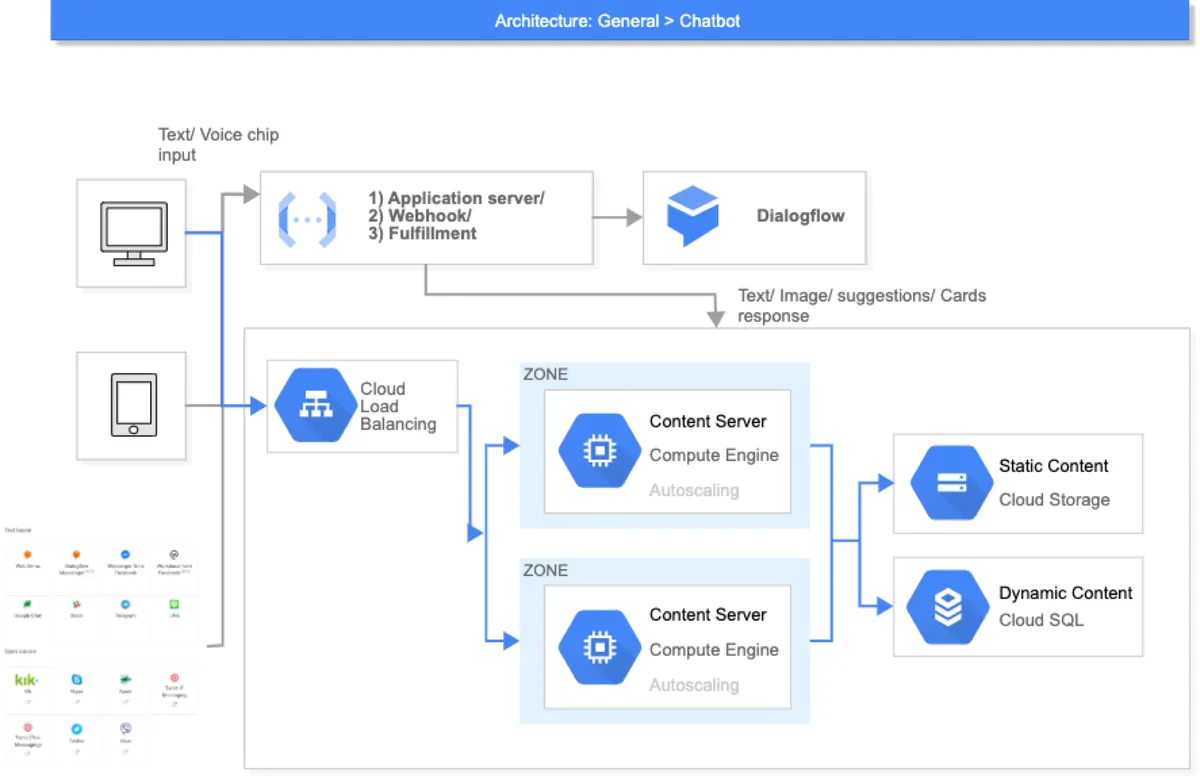
在本文中,我們將介紹如何使用OpenAI技術以及從網站中提取的相似詞嵌入,使用Python創建一個簡單的Q&A聊天機器人。我們將討論機器人的簡單架構和程式結構,並提供實際的程式碼範例和預期的結果。
步驟1:準備環境和所需工具
首先,確保您的電腦上已安裝了Python和所需的庫,包括OpenAI和Sentence Transformers。您可以使用以下命令安裝所需的庫:
pip install openai sentence-transformers beautifulsoup4
步驟2:擷取相關文本數據
我們將使用BeautifulSoup從預設的網站中提取相關的問題和答案數據,以下是一個簡單的程式碼示例:
from bs4 import BeautifulSoup
import requests
url = "http://www.xxx.com/faq/"
response = requests.get(url)
soup = BeautifulSoup(response.content, "html.parser")
questions = []
answers = []
for faq in soup.find_all("div", class_="faq"):
question = faq.find("div", class_="faq-question").get_text()
answer = faq.find("div", class_="faq-answer").get_text()
questions.append(question)
answers.append(answer)
步驟3:使用OpenAI建立Q&A模型
我們將使用OpenAI的技術來建立一個Q&A模型,使我們的聊天機器人能夠回答用戶的問題,以下是一個簡單的程式碼範例:
import openai
openai.api_key = "您的OpenAI API金鑰"
def generate_answer(question, context):
prompt = f"Question: {question}\nContext: {context}\nAnswer:"
response = openai.Completion.create(
engine="davinci",
prompt=prompt,
max_tokens=50
)
answer = response.choices[0].text.strip()
return answer
步驟4:使用Sentence Transformers進行嵌入搜尋
現在,我們將使用Sentence Transformers來搜尋最相似的問題,以便為用戶提供更好的答案。以下是一個簡單的程式碼示例:
from sentence_transformers import SentenceTransformer, util
# 加載Sentence Transformers模型
model = SentenceTransformer('paraphrase-MiniLM-L6-v2')
# 將所有問題嵌入
question_embeddings = model.encode(questions, convert_to_tensor=True)
def find_most_similar_question(user_question, question_list, embeddings):
user_question_embedding = model.encode(user_question, convert_to_tensor=True)
cos_scores = util.pytorch_cos_sim(user_question_embedding, embeddings)[0]
most_similar_index = cos_scores.argmax()
most_similar_question = question_list[most_similar_index]
return most_similar_question
# 在聊天機器人循環中使用
while True:
user_question = input("請輸入您的問題:")
most_similar_question = find_most_similar_question(user_question, questions, question_embeddings)
answer = generate_answer(user_question, most_similar_question)
print("機器人回答:", answer)
結論
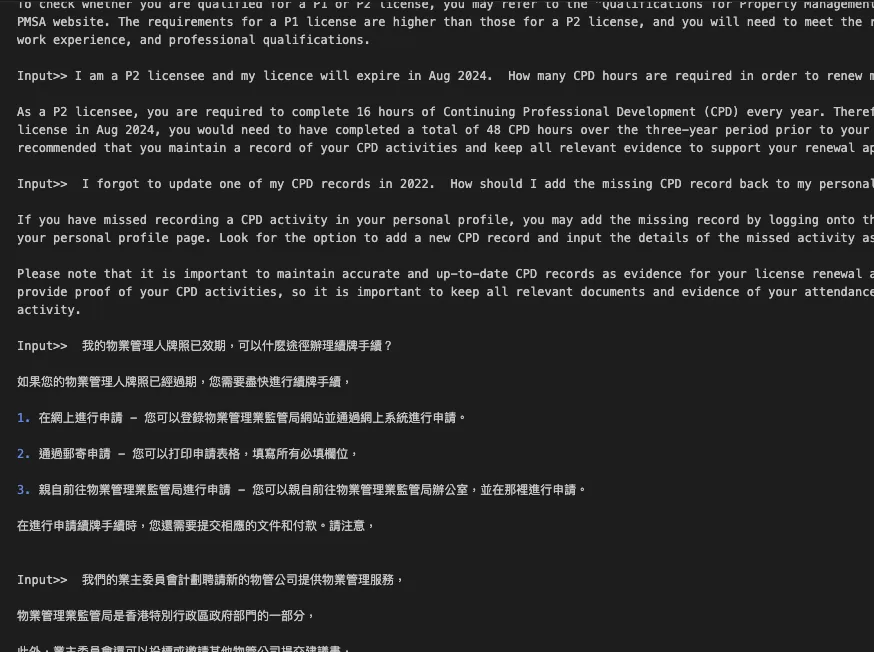
通過這個指南,您學會了如何使用OpenAI技術和Sentence Transformers庫,從網站提取數據並使用嵌入搜尋算法,使用Python在一小時內創建一個具有更好問題相似性的Q&A聊天機器人。這個機器人能夠根據用戶的問題提供更相關的答案,提升用戶體驗。您可以根據需求進一步擴展和改進這個機器人,以滿足特定的需求。
提高聊天機器人準確性的進一步優化
雖然我們已經創建了一個簡單且功能齊全的Q&A聊天機器人,但是我們可以進一步優化它,以獲得更準確的結果。以下是兩個方法,可以幫助我們達到更高的準確性。
1. 增加數據量
我們可以通過收集更多的問題和答案數據,來增加聊天機器人的知識庫。這將使機器人更有能力回答更廣泛的問題,並提供更多準確的答案。您可以從不同來源獲取相關數據,並將其整合到機器人的訓練數據中。更多的數據將有助於提高模型的整體表現。
2. 調整OpenAI API調用的'Temperature'
在之前的代碼中,我們使用了OpenAI的API來生成答案,並且沒有指定'temperature'參數。'Temperature'參數控制了生成文本的隨機性,高溫值會產生更隨機的文本,而低溫值則會產生更確定性的文本。如果您發現生成的答案過於模棱兩可或不夠確定,您可以調整'temperature'參數來獲得更適合的答案。通過實驗,您可以找到最適合您機器人的'temperature'值,以獲得更準確且合適的回答。
透過這些優化方法,我們可以提高聊天機器人的準確性和實用性,使其能夠更好地回答用戶的問題。通過不斷調整數據和模型參數,我們可以使機器人成為一個更強大的工具,為用戶提供更有價值的信息和答案。